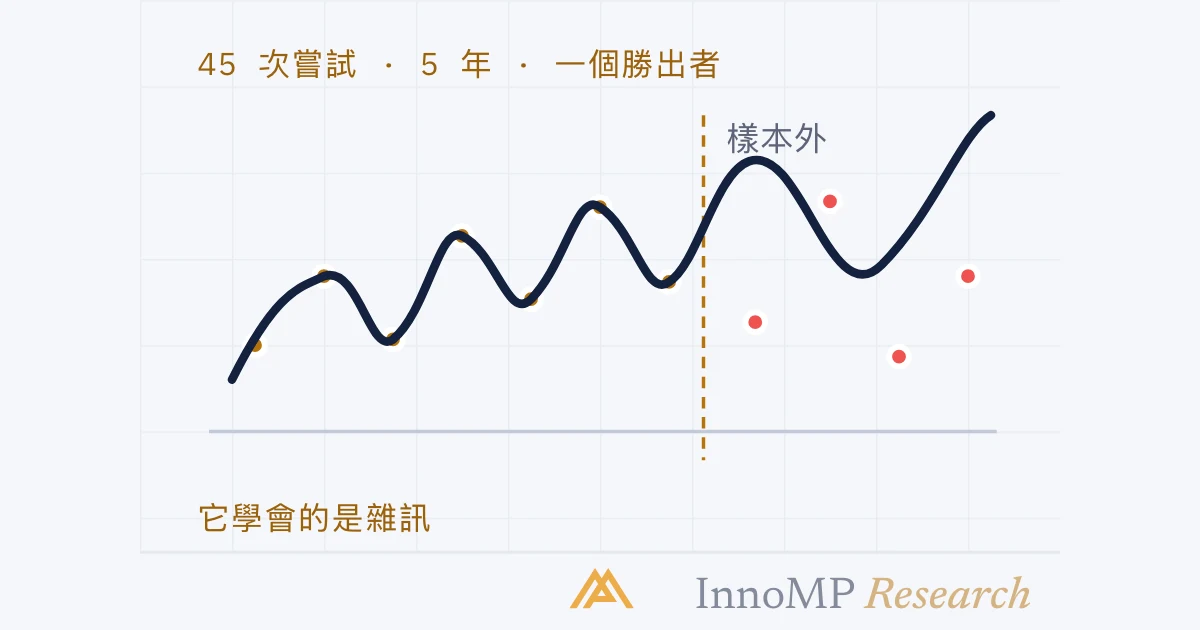
過度擬合(overfitting)是把一條規則調整到貼合測試樣本中的雜訊,以致其紀錄無法延續到新的數據。它來自嘗試次數:在十種毫無真正優勢的配置之中,表現最好的一種,預期樣本內 Sharpe 比率接近 1.6;有五年數據時,45 次嘗試就足以產生一種在樣本內看似有實力、在樣本外平均為零的配置。防範方法是:計算每一次嘗試、預留規則從未見過的數據、以前推方式進行測試,以及選擇參數的高原而非尖峰。
過度擬合(overfitting)是把一條規則調整到貼合測試樣本中的雜訊,以致其紀錄無法延續到新的數據。它來自嘗試次數,而不是來自任何一次測試——而嘗試次數,正是證據中幾乎從來沒有被寫下來的那一部分。在眾多回測之中,最好的那一個,數字的意義最小。
第 11 篇和第 12 篇假設只有一份如實保存的紀錄。這一篇講的是那些沒有被保存的紀錄:在得出筆記簿上那一版規則之前,一路嘗試過又丟棄的各個版本。它們改變了留下來的那份紀錄的意義,而處理它們的工具,比交易本身還要古老。
貼合訊號,貼合雜訊
任何一組過去的交易都包含兩樣東西:會重複出現的,以及只發生過一次的。一條有足夠多可調部件的規則,可以被扭曲到兩者都貼合。
在一套交易設置裡,可調的部件就是參數:止蝕的 ATR 倍數、回看期、交易時段過濾、最小回調深度,以及某個糟糕的星期五之後加上去的「星期幾不交易」。每一個都是一個旋鈕,而在同一組數據上試過的每一個數值,都是一次貼合偶然的機會。過度擬合——舊說法叫曲線擬合(curve fitting)——就是交易設置在調整用數據上紀錄出色、在其他任何數據上卻表現平平甚至更差時,它所做過的事。做這件事的交易者很少察覺,因為從內部看,每一次調整都像是在學習。
N 次中的最佳,並不是最佳
這個機制並不隱晦。2014 年,Bailey、Borwein、López de Prado 及 Zhu 在《Notices of the American Mathematical Society》發表的一篇論文,為它定出了數字。假設一位研究者嘗試某個策略的 N 種配置,而其中沒有一種具備真正的優勢——每一種的真實 Sharpe 比率都是零。這 N 種之中最好的一種,在樣本上量度出來的結果不會是零。它會顯示 N 個偶然結果的預期最大值,而這個數字會隨 N 增大。
Sharpe 比率是這一組已經用過的一個比率的金融版本:平均回報除以回報的離散程度,再年化——也就是期望值除以其標準差,用的是第 11 篇的單位。論文的例子是十種配置,全部毫無實力,其中最好的一種預期會顯示 1.57 的樣本內 Sharpe 比率。主觀交易者不會計算 Sharpe 比率,但這個邏輯可以原封不動地套用:同一套交易設置的十個版本,在同一年的圖表上調整,其中最好的一個,期望值因為挑選而被誇大;而第 11 篇的誤差範圍——按它是唯一一個版本來計算——則過窄,窄多少,取決於被丟掉的那九個。
整個問題可以用一句話說完:在知道落敗者有多少之前,勝出者的紀錄並不是關於勝出者的證據。
最短回測長度
論文把同一道算術變成一條經驗法則,稱為最短回測長度(minimum backtest length):所需的數據年數,使得 N 次嘗試中最好的一次,不會被預期純屬偶然地達到某個樣本內 Sharpe 比率。
論文本身的例子就是圖中的兩個:五年數據最多支持約四十五種獨立配置,之後就預期會有一種毫無實力的配置看似擁有 Sharpe 比率 1;兩年數據約支持七種。作者小心地說明這個數字不是甚麼。它假設各次嘗試互相獨立,因此偏向保守——同一個止蝕倍數的十個數值,並不是十個獨立的想法——而且它是必要條件,不是充分條件:即使樣本遠長於最短長度,回測仍然可能過度擬合。它是甚麼?它是對一份紀錄的一個多數人從來不問的問題——它是由多少次嘗試產生的——的第一個答案。作者的核心不滿是:這個數字幾乎從來不被公開,無論在學術論文中,還是由任何推銷某個結果的人,以致單憑結果本身,無法評估過度擬合的風險。
對主觀交易者來說,嘗試次數不多,數據也很短。兩個貨幣對一年的四小時圖表,加上一套止蝕倍數、交易時段過濾和回調深度各試了三個數值的交易設置,就是一年數據上的二十七種配置——已經越過論文的界線。勝出者的紀錄也許仍然沒問題,只是它還不算證據。
預留數據
最古老的補救方法,是把部分數據留在調整過程之外。
樣本外測試(out-of-sample test)是把一條規則,原封不動地在從未用來調整它的數據上運行一次。如果樣本外紀錄與樣本內紀錄相似——期望值在同一個數量級、區間互相重疊——規則學到的東西在調整數據之外仍然持續。如果紀錄崩潰,樣本內的數字就是雜訊。全部紀律都在「一次」這兩個字裡:預留數據一被看過就用掉了,看過之後作出的任何調整,按定義都會令下一次運行變成樣本內。論文也指出這個方法的局限——預留數據不知道之前有過多少次嘗試,所以一條通過預留測試的規則,在另一種意義上仍然是 N 次中的最佳——但作為第一道過濾,它能清除上一節所描述的大部分問題。
中級的前向測試是同一個想法,只是數據由日曆而非檔案庫提供:即時進行的模擬交易不可能被用來調整過,因為它們當時還沒有發生。
前推測試
單一切分只把數據用一次。前推測試則反覆使用數據,在同一段歷史上得到一份更長的樣本外紀錄。
前推測試(walk-forward test)是在整段歷史中重複進行的樣本外測試:在第一個窗口上調整,在其後的期間測試,把兩者按測試期的長度向前推移,再把各段測試期拼接起來。拼接出來的紀錄具備關鍵的特性——沒有任何一部分被用來調整過——而且長得足以有自己的誤差範圍。它還產生一樣單一切分不會產生的東西:每個窗口所選參數的序列。如果測試結果最好的止蝕倍數,在一個窗口是 1.5,下一個是 2.5,第三個是 1.2,這條規則就沒有穩定的參數,而每個窗口重新調整一次,本身就是過度擬合——只不過是按時間表進行。
選高原,不選尖峰
最後一道防線,關乎在一個窗口之內如何選擇參數,而且完全不需要預留數據。
把一個參數在其合理範圍內掃描一遍,並把結果相對它畫出來。有效的規則會有一片高原:一段結果相近的數值,因為規則所捕捉的市場特徵對確切的數字並不敏感。貼合雜訊的規則會有一個尖峰:一個比相鄰數值好得多的數值,因為那個數值剛好捕捉到這個樣本的偶然。尖峰永遠是最大值,所以選最大值正是錯誤所在。在高原之內選一個數值——選它的中間,而不是它上面最好的一點——規則在調整數據上會損失一點,在其他地方則能保住大部分。
重點 N 次嘗試中最好的一次,預期會因為偶然而看起來不錯,而且好到甚麼程度,隨 N 增大。計算嘗試次數,並把次數與紀錄放在一起。把數據預留起來,只用一次。以前推方式測試,除了拼接紀錄,也要解讀參數的序列。在一個窗口之內,選高原,不選尖峰。
嘗試紀錄
以上種種,歸結為對交易心理課程所建立的交易日誌的一項補充:一份嘗試紀錄。每一種試過的配置、試用的數據、結果,以及放棄它的原因——包括那些只在腦海裡試了一個下午就放棄的,因為論文的重點正是這些也要計算在內。這份紀錄做三件事。它給出 N,讓倖存者的數字可以對照落敗者的數目來解讀。它記下參數掃描,讓日後樣本更長時,可以分辨尖峰和高原。它還令各次調整以「調整」的面目顯現出來,這是唯一能對抗那種從內部看、每一次調整都像在學習的感覺的方法。
論文的最後一個觀察,正好用來作結。當嘗試次數沒有被計算時,一個好的回測不只是沒有資訊價值;在有記憶性的數據上——被貼合過的一段時期,往往接著出現相反的走勢——作者指出,過度擬合規則的樣本外預期值是負數。他們寫道,在這種情況下,「過往表現並不代表未來結果」這句慣常的警告,還是太樂觀了。一份經過挑選的紀錄,不只是一個微弱的訊號,它可能是一個指向錯誤方向的訊號。
紀錄走到哪裡
這一組到此完結。一份紀錄現在帶有三樣在中級結束時沒有的東西:期望值的誤差範圍、圍繞回撤的分佈,以及背後的嘗試次數。一套交易設置,若其區間在扣除成本後仍然為正、其回撤尾部已按倉位大小預留、其嘗試次數少而且有寫下來,就具備這一級所說的唯一意義上的交易優勢。這一級的最後一組——第 14 至 16 篇——把一套已通過檢驗的交易設置,變成可以運行的東西:一張決策表、提示與執行規則,以及檢討週期與停用準則。
下一篇:從規則到決策表——市場的每一種狀態都有一個直欄,文字描述所隱藏的漏洞與矛盾都會浮現出來。- 在 10 種真實 Sharpe 比率為零的配置之中,表現最好的一種,預期樣本內 Sharpe 比率為 1.57(Bailey、Borwein、López de Prado 及 Zhu,2014)。
- 有 5 年數據時,嘗試的獨立配置不應超過 45 種,否則預期會有一種毫無實力的配置達到樣本內 Sharpe 比率 1;只有 2 年數據時,這個數字是 7。
- 回測背後的嘗試次數幾乎從不公開,因此單憑結果本身,無法評估其過度擬合的風險。
- 過度擬合規則的樣本外表現,若序列沒有記憶性,預期約為零;若有記憶性,則預期為負。
- 樣本外測試預留規則從未用來調整的數據;前推測試(walk-forward test)則在整段歷史中逐個窗口重複這種切分。