跳至主要內容
研究 / 教育 / 交易日誌

技術分析 · 專業 · 第 11 篇,共 16 篇

附誤差線的期望值:交易紀錄能讓你有多肯定

一份紀錄顯示每筆交易 +0.25R。問題是真實數字可能離它有多遠。如何為期望值加上標準誤和置信區間,以及要多少筆交易,才能把優勢與零區分開來。

InnoMP Research · Education Desk 發佈於 2026年10月25日 · 更新於 2026年10月25日 9 分鐘閱讀
InnoMP Research 封面插圖 — 一個數字 及其誤差
重點摘要

附誤差線的期望值,是指在報告每筆交易平均 R 的同時,一併報告它的標準誤——交易結果的標準差除以交易數目的平方根——以及由此得出的置信區間。一份 60 筆交易、平均 +0.25R、標準差 1.2R 的紀錄,標準誤約為 0.15R,因此 95% 區間約由 −0.05R 至 +0.55R:這個優勢還無法與「沒有優勢」區分開來。區間隨樣本的平方根收窄,所以要把它減半,就需要四倍的交易。

附誤差線的期望值,是指在報告每筆交易平均 R 的同時,一併報告它的標準誤,以及由此得出的置信區間——讓紀錄被解讀為一個範圍,而不是一個數字。一份 60 筆交易、平均 +0.25R 的紀錄,並未顯示出優勢。它顯示的是一個誤差線延伸到零以下的數字。

中級課程以一本筆記簿作結:交易設置本會作出的每一筆交易,以及把這份清單變成勝率、平均盈利與平均虧損,以及期望值的算術。那一篇為勝率加上了誤差線。這一組為真正重要的數字——期望值本身——做同樣的事,然後提出紀錄單憑自身無法回答的兩個問題:它的回撤本來可以有多差,以及規則是否被擬合到測試它的那段過去。

紀錄是一個樣本

60 筆交易是一個過程的樣本。在另外 60 筆上運行同一套交易設置——下一年、另一個貨幣對——平均數會落在別處。它典型的變動距離就是標準誤(standard error):各筆交易結果(以 R 計)的標準差,除以交易數目的平方根。

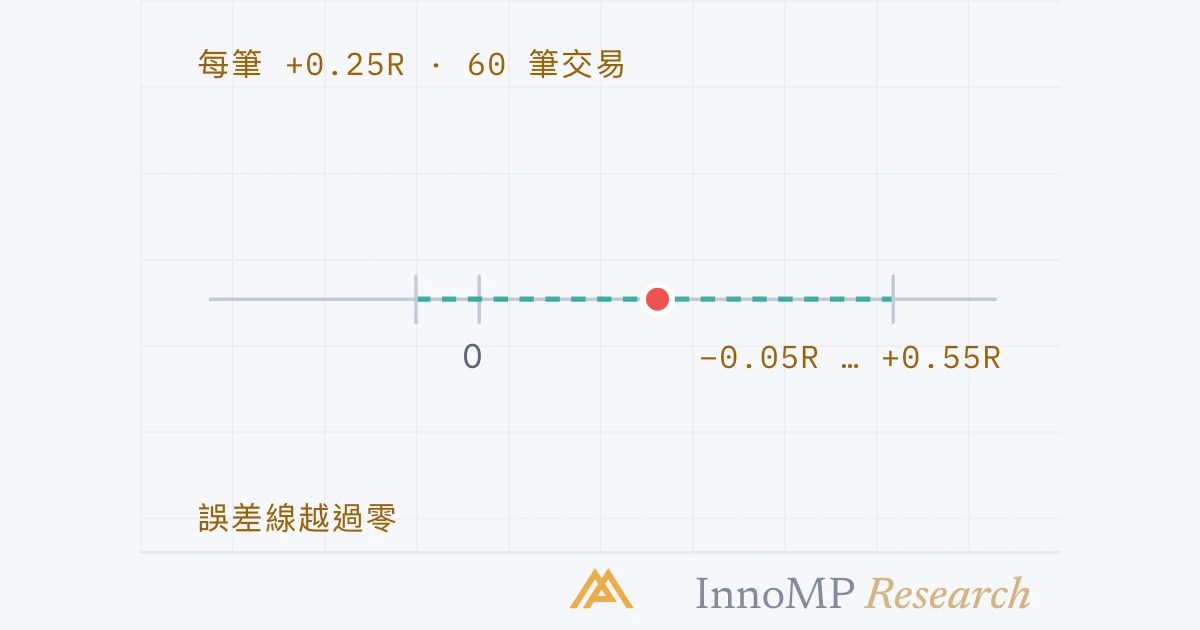
一份紀錄,畫成一個點加一條誤差線 一條以 R 計的橫向數線,由負 0.5R 到正 1.5R。正 0.25R 處有一個點,是紀錄 60 筆交易的平均數,周圍有一條由負 0.05R 延伸到正 0.55R 的粗線,即 95% 區間。一條垂直虛線標示零,而那條粗線越過了它。 60 筆交易 · 平均 +0.25R · 標準差 1.2R−0.5R0+0.5R+1R95% 區間:−0.05R 至 +0.55R越過零 InnoMP Research
60 筆交易,平均 +0.25R,結果的標準差為 1.2R。標準誤是 1.2 除以 60 的平方根——約 0.15R——而 95% 區間大約是平均數兩邊各兩個標準誤。它延伸到零以下。

置信區間(confidence interval)是平均數加減標準誤的某個倍數——95% 區間的倍數是一個 t 值,樣本超過幾十筆交易後就接近 2。NIST 手冊對它的含義說得很精確,而這種精確很重要:它不是指真實期望值有 95% 的機率落在這條線之內。它是指:如果收集許多份 60 筆交易的紀錄,並為每一份計算區間,這些區間中約有 95% 會包含真實值。這一條是其中之一,而它屬於那 95% 還是那 5%,從它內部無法得知。

能夠得知的是它的寬度,而寬度正是重點。由 −0.05R 至 +0.55R 的區間,包含一套慢慢虧損的交易設置、一套每筆交易賺半個 R 的交易設置,以及介乎兩者之間的一切。紀錄已經收窄了可能性;它還沒有在其中作出選擇。

為甚麼是平方根

標準誤隨樣本的平方根收窄,而不是隨樣本本身收窄。紀錄加倍,誤差線並不會減半。

誤差線隨樣本的平方根收窄 五條橫向長條,分別代表 30、60、120、300 和 1,000 筆交易的樣本,各自顯示結果標準差為 1.2R 時的標準誤:0.22R、0.15R、0.11R、0.07R 和 0.04R。每一條比上一條短的比例,是樣本比例的平方根,而不是樣本比例本身。 標準差 1.2R · 標準誤 = 1.2 / √NN = 30±0.22RN = 60±0.15RN = 120±0.11RN = 300±0.07RN = 1,000±0.04R交易數目增至四倍,誤差線減半 InnoMP Research
結果圍繞平均數的標準差為 1.2R。由 30 筆交易增至 120 筆——樣本變成四倍——標準誤減半;再增至 1,000 筆,則減至大約三分之一。精度的價錢越來越高。

這就是中級課程一條規則背後的算術,那一級只說了規則而沒有給出算術:交易要比你覺得需要的更多。這也是為甚麼那一篇引用的勝率區間——30 筆交易時上下各約 18 個百分點,300 筆時約 6 個——是那個形狀。勝率是一個比例,而比例的標準誤也按同一個平方根收窄。

離散程度與數目同樣重要

標準誤的另一項是結果的離散程度(標準差),而離散程度是交易設置的特性——取決於它如何出場——而不是市場的特性。

平均數相同、樣本相同,離散程度不同 兩個面板。左邊是集中,結果標準差 0.8R:平均正 0.25R,95% 誤差線約為正負 0.2R,越過零以上。右邊是分散,結果標準差 2R:60 筆交易時同樣的平均數,誤差線約為正負半個 R,越過零。兩者都來自 60 筆交易。 集中 · 標準差 0.8R60 筆交易時 ±0.2R越過零分散 · 標準差 2.0R60 筆交易時 ±0.5R仍然未知 InnoMP Research
兩套在 60 筆交易中期望值相同的交易設置。結果聚集在平均數附近的那一套已經越過零;把小額虧損與罕見大額盈利混在一起的那一套還沒有,需要大約六倍的交易才能同樣肯定。

一套虧損 1R、盈利 1.5R 的交易設置,結果貼近它們的平均數。一套虧損 1R、偶爾盈利 6R 的交易設置——順勢交易的形態,大部分交易打和、少數幾筆支撐全年——結果的離散程度超過前者兩倍,在任何樣本下標準誤也超過兩倍。第二套交易設置可以有較高的期望值,卻仍是較難證明的一套。這不是偏好任何一套的理由;而是在決定筆記簿能說明多少之前,要先知道筆記簿裡是哪一種的理由。

解讀區間

區間畫出來之後,它相對於零只有三種可能。

三份紀錄,各有一種解讀 三條橫向區間線,對照一條垂直的零虛線。紀錄 A 完全位於零的右邊,標示為扣除成本後的優勢。紀錄 B 橫跨零,標示為尚未可知。紀錄 C 大部分位於零的左邊並觸及零,標示為未顯示優勢。 0R紀錄 A扣除成本後的優勢紀錄 B尚未可知紀錄 C未顯示優勢 InnoMP Research
A 是優勢在紙面上的樣子:整條線在零以上,而且是扣除成本後。B 是大部分 60 筆交易的紀錄。C 是紀錄已經在反對的交易設置,不論最近幾筆交易感覺如何。

這一級就是在這個意義上使用這個詞。優勢(edge)是扣除點差和隔夜利息後仍為正、而且置信區間位於零以上的正期望值。單單一個正數不是優勢;它是紀錄 B,而在手動重播所能產生的樣本大小下,幾乎每一份紀錄看起來都像紀錄 B。對 B 誠實的解讀不是「有效」或「無效」,而是「繼續數下去」——這是關於時間和模擬交易的決定,不是關於金錢的決定。

成本移動它;樣本收窄它

區間是按未扣成本的結果畫出來的。一筆交易的真正成本——點差、隔夜利息、滑點——要從每一筆中扣除,而以 R 計,對某一套交易設置而言它是每筆交易固定的數額,因為止蝕是同樣這些東西的固定倍數。

成本令區間移位;只有樣本能令它收窄 兩條橫向區間線,對照一條零虛線。扣除成本前:平均正 0.25R,區間由負 0.05R 至正 0.55R。每筆扣除 0.1R 成本後:同一條線向左移,平均正 0.15R,由負 0.15R 至正 0.45R。兩條線寬度相同。 0R扣除成本前扣除 0.1R 成本後寬度相同,中心較低要越過成本,不只是零 InnoMP Research
每筆交易十分之一個 R 的點差和隔夜利息,令整個區間向下移十分之一個 R,寬度則完全不變。問題從來不是線是否越過零,而是它是否越過成本。

兩個後果。一套未扣成本時優勢細小的交易設置,扣除成本後可能完全沒有優勢,而在逐筆輸入成本之前,紀錄不會顯示這一點——這就是為甚麼中級課程的筆記簿有一欄記錄成本。而比較兩套交易設置,就是比較扣除成本後的區間:交易較頻繁的交易設置付出成本的次數也較多,它的區間就低得更多。

重點 紀錄的期望值是一個點;它的標準誤是結果的標準差除以交易數目的平方根;置信區間大約是平均數兩邊各兩個標準誤。成本令區間向下移。只有更多的交易——多得多的交易——才能令它收窄。當誤差線在扣除成本後位於零以上,交易設置才有優勢,在此之前沒有。

要多少筆交易

中級課程以「比你覺得需要的更多」回答的那個問題,有一個算術答案,值得一看,因為它比直覺所容許的更大。

把期望值與零區分開來所需的交易數目 兩欄。左邊,區間以 95% 剛好越過零:正 0.5R 的期望值約需 23 筆交易,正 0.25R 約需 89 筆,正 0.1R 約需 550 筆。右邊,按 NIST 樣本大小公式以 90% 檢定力檢測出來:約 61、243 和 1,514 筆。兩者都假設結果標準差為 1.2R。 剛好越過零+0.5R · 約 23 筆交易+0.25R · 約 89 筆+0.1R · 約 550 筆95% 區間可靠地檢測出+0.5R · 約 61 筆交易+0.25R · 約 243 筆+0.1R · 約 1,514 筆90% 檢定力 · NIST InnoMP Research
左邊:圍繞真實期望值的 95% 區間剛好排除零時的樣本。右邊:NIST 公式為可靠地檢測出該期望值所要求的樣本,錯過的機會是十分之一。優勢減半,兩者都變成四倍。

左欄是把標準誤倒過來計:兩個標準誤等於期望值時的樣本,即假如紀錄的平均數就是真實值,區間剛好會排除零。右欄是 NIST 手冊中、檢測某個大小的偏移所需樣本的公式——兩個 z 值之和的平方,乘以離散程度除以偏移的平方——採用慣常的 5% 假陽性機會和 10% 錯過機會。它大約是左欄的 2.7 倍,因為它要求的不只是誤差線有可能越過零,而是十次中有九次會越過零。

兩欄對細小的優勢都說明同一件事。十分之一個 R 的期望值是真實的優勢——一千筆交易下來就是一百個 R——但一套每星期觸發兩次的交易設置,五年內也無法證明它。能夠以主觀交易紀錄驗證的交易設置,是那些每筆交易的優勢相對其結果離散程度較大的交易設置。這是這一級能夠誠實地稱為優勢的東西的一個限制,在打開筆記簿之前知道,比之後才知道好。

區間說不出甚麼

區間描述的是平均數,而且把紀錄當成一袋互相獨立、次序無關的結果。有兩件事是它捕捉不到的。交易的次序確實重要,對回撤的一切都重要——一份期望值不錯的紀錄,仍可能是經由一條交易者撐不過去的路徑得來的,而下一篇會對紀錄重抽樣,看看其他路徑有多差。而且紀錄被假定是唯一的一份:如果它是同一條規則十個版本中最好的一個,區間就太窄了,窄多少取決於那十個版本,這一組就在那裡作結。

下一篇:蒙地卡羅模擬與回撤——對紀錄中的交易重抽樣,看看它的次序隱藏了哪些回撤,並決定倉位大小,使差的抽樣結果也撐得過去。

關鍵事實
  • 期望值是每筆交易的平均 R;它的標準誤是交易結果的標準差除以交易數目的平方根。
  • 平均數的置信區間是平均數加減一個 t 值乘以標準誤,並隨樣本的平方根收窄(NIST e-Handbook)。
  • 舉例說明:60 筆交易、平均 +0.25R、標準差 1.2R,95% 區間約為 −0.05R 至 +0.55R;300 筆交易把它收窄至約 +0.11R 至 +0.39R。
  • 交易數目增至四倍,誤差線減半;要在較小的優勢上得到同樣精度,需要按比例更多的交易。
  • 點差和隔夜利息(swap)會把整個區間向下移,卻不會令它收窄,所以優勢要在扣除成本後判斷。
常見問題

期望值的標準誤是甚麼?

各筆交易結果(以 R 計)的標準差,除以交易數目的平方根。它是紀錄所顯示的期望值,與交易設置實際擁有的期望值之間的典型距離。一份交易結果圍繞平均數、標準差為 1.2R 的紀錄,60 筆交易時標準誤約為 0.15R,300 筆時約為 0.07R。

怎樣為交易紀錄加上置信區間?

計算每筆交易的平均 R 和 R 結果的標準差,把標準差除以交易數目的平方根得出標準誤,再以平均數加減大約兩個標準誤,得出 95% 區間。如果區間包含零,紀錄還未顯示出優勢;如果扣除成本後區間完全位於零以上,就顯示出來了。

要多少筆交易才能證明有優勢?

取決於優勢相對於結果離散程度的大小。結果標準差為 1.2R 時,+0.5R 的期望值約在 23 筆交易後以 95% 越過零,+0.25R 約需 89 筆,+0.1R 約需 550 筆。採用 90% 檢定力的樣本大小公式,這些數字大約乘以 2.7。較小的優勢需要的交易多得多,而不只是多一點。

期望值為正,是否代表交易設置有效?

單憑這一點不是。一個正數加上一個延伸到零以下的區間,就像一枚硬幣在短時間內擲出公字的次數比字略多。當區間在扣除點差和隔夜利息後位於零以上、樣本大到接下來幾筆交易無法令它移動,而且它產生的回撤是撐得過的,交易設置才算有效——下一篇會講最後一點。

為甚麼勝率也有誤差線?

因為它是在樣本上量度的比例,而比例也有同樣的問題:40 筆交易得出的 55% 勝率,可以落在約 40% 至 70% 之間的任何位置。中級課程給出了它的二項區間。期望值把勝率與平均盈利和平均虧損結合起來,所以它的誤差線承繼了三者的不確定性,這就是為甚麼要直接由 R 結果量度,而不是由各部分拼湊出來。

資料來源

  1. NIST/SEMATECH e-Handbook of Statistical Methods — Confidence limits for the mean: Ȳ ± t(1−α/2, N−1) · s/√N; the interval narrows with √Nitl.nist.gov
  2. NIST/SEMATECH e-Handbook — Sample sizes required to detect a shift δ: N = (z(1−α/2) + z(1−β))² (σ/δ)²itl.nist.gov
  3. NIST/SEMATECH e-Handbook — Confidence intervals for a binomial proportion (the win-rate interval used at the Intermediate level)itl.nist.gov
InnoMP Research · Education Desk

Trading education from first principles — position sizing, risk, market structure and the habits that keep accounts alive. Written for someone who has never opened a chart, with a diagram at every step.

發佈於 2026年10月25日 · 更新於 2026年10月25日

免責聲明: 本網站資料只供一般資訊用途,不構成投資建議、要約或買賣任何金融工具的招攬。內容並未考慮你的個人財務狀況或投資目標。公司不對因交易活動造成的損失承擔責任。交易前請閱讀法律文件並尋求獨立專業意見。

相關文章

InnoMP Research 封面插圖 — 每種狀態 都有答案
紀律

交易決策表:讓市場的每一種狀態都有答案

書面的交易設置仍然留有漏洞:有些市場狀態,文字從未提及。如何把規則排成一張決策表——條件列在左側,每條規則佔一個直欄——並先把漏洞與矛盾找出來。

9 分鐘閱讀
InnoMP Research 封面插圖 — 四十五次 中的最佳
交易日誌

過度擬合與樣本外測試:為何最好的回測最不可信

同一條規則試過足夠多的版本,總有一個會碰巧在過去的數據上表現亮眼。甚麼是過度擬合、為何嘗試次數比勝出者的數字更重要,以及預留數據和前推測試如何分辨擬合與運氣。

10 分鐘閱讀