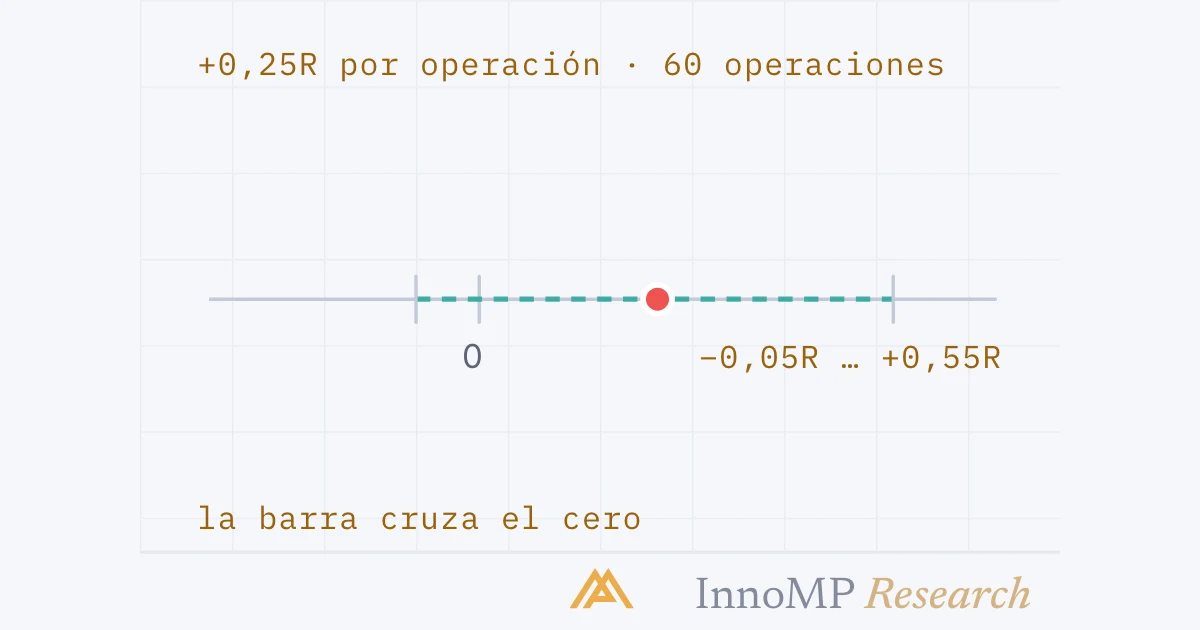
La esperanza matemática con barras de error es dar la R media por operación con su error estándar (la dispersión de los resultados entre la raíz cuadrada del número de operaciones) y el intervalo de confianza que se deriva. 60 operaciones con media de +0,25R y dispersión de 1,2R dan un error estándar de unos 0,15R; el intervalo del 95% va de −0,05R a +0,55R: la ventaja aún no se distingue de cero. El intervalo se estrecha con la raíz de la muestra: reducirlo a la mitad exige cuatro veces más operaciones.
La esperanza matemática con barras de error consiste en dar la R media por operación junto con su error estándar y el intervalo de confianza que se deriva de él, de modo que un registro se lee como un rango y no como un número. Un registro de sesenta operaciones a +0,25R no ha demostrado una ventaja. Ha mostrado un número cuya barra de error llega por debajo de cero.
El nivel Intermedio terminó con un cuaderno: todas las operaciones que un setup habría tomado y la aritmética que convierte la lista en una tasa de acierto, una ganancia y una pérdida medias y una esperanza matemática. Aquella parte dio barras de error a la tasa de acierto. Este grupo hace lo mismo con el número que importa, la propia esperanza matemática, y luego plantea las dos preguntas que un registro no puede responder por sí solo: cuán malos podrían haber sido sus drawdowns (caídas del capital) y si las reglas se ajustaron al pasado con el que se probaron.
El registro es una muestra
Sesenta operaciones son una muestra de un proceso. Aplique el mismo setup a otras sesenta (el año siguiente, otro par) y la media saldrá en otro sitio. La distancia que suele moverse es el error estándar: la desviación estándar de los resultados de cada operación, en R, dividida por la raíz cuadrada del número de operaciones.
El intervalo de confianza es la media más o menos un múltiplo del error estándar: para un intervalo del 95%, un valor t cercano a dos cuando la muestra supera unas pocas decenas de operaciones. El manual del NIST es preciso sobre lo que significa, y la precisión importa: no es una probabilidad del 95% de que la esperanza verdadera esté dentro de esta barra. Significa que, si se reunieran muchos registros de sesenta y se calculara el intervalo para cada uno, alrededor del 95% de esos intervalos contendrían el valor verdadero. Este es uno de ellos, y si está entre el 95% o entre el 5% no se puede saber desde dentro.
Lo que sí se puede saber es su anchura, y la anchura es lo importante. Un intervalo de −0,05R a +0,55R contiene un setup que pierde poco a poco, un setup que gana media R por operación y todo lo que hay entre ambos. El registro ha acotado las posibilidades; no ha elegido entre ellas.
Por qué la raíz cuadrada
El error estándar se reduce con la raíz cuadrada de la muestra, no con la muestra. Duplicar el registro no reduce la barra a la mitad.
Es la aritmética que hay debajo de una regla que el nivel Intermedio enunció sin ella: más operaciones de las que parecen necesarias. Es también la razón por la que el intervalo de la tasa de acierto que citaba aquella parte (unos dieciocho puntos a cada lado con treinta operaciones, unos seis con trescientas) tiene la forma que tiene. La tasa de acierto es una proporción, y el error estándar de una proporción se reduce con la misma raíz cuadrada.
La dispersión importa tanto como el recuento
El otro término del error estándar es la dispersión de los resultados, y la dispersión es una propiedad del setup (de cómo sale de las operaciones), no del mercado.
Un setup que pierde 1R y gana 1,5R tiene resultados que quedan cerca de su media. Un setup que pierde 1R y de vez en cuando gana 6R (la forma del seguimiento de tendencia, en la que la mayoría de las operaciones salen sin resultado y unas pocas pagan el año) tiene una dispersión más del doble de amplia, y su error estándar es más del doble con cualquier muestra. El segundo setup puede tener la esperanza más alta y ser aun así el más difícil de demostrar. No es una razón para preferir ninguno; es una razón para saber cuál de los dos hay en el cuaderno antes de decidir cuánto puede decir el cuaderno.
Leer el intervalo
Una vez dibujado el intervalo, solo puede estar haciendo tres cosas respecto al cero.
Este es el sentido en el que el nivel usa la palabra. Una ventaja es una esperanza matemática positiva que sigue siendo positiva después del spread y el swap y cuyo intervalo de confianza queda por encima de cero. Un número positivo por sí solo no lo es; es el registro B, y el registro B es el aspecto de casi todos los registros con el tamaño que produce una reproducción manual. La lectura honesta de B no es “funciona” ni “no funciona”, sino “siga contando”, que es una decisión sobre tiempo y operaciones en demo, no sobre dinero.
Los costes lo desplazan; la muestra lo estrecha
El intervalo se dibujó con resultados brutos. El coste real de una operación (spread, swap, deslizamiento) se resta de cada uno, y en R es una cantidad fija por operación para un setup dado, porque el stop es un múltiplo fijo de esas mismas cosas.
Dos consecuencias. Un setup con una ventaja bruta pequeña puede no tener ninguna en neto, y el registro no lo revelará hasta que los costes se anoten operación por operación; por eso el cuaderno del nivel Intermedio tiene una columna para ellos. Y la comparación entre dos setups es una comparación de intervalos netos: un setup que opera más a menudo paga el coste más a menudo, y su intervalo baja más.
Idea clave La esperanza matemática de un registro es un punto; su error estándar es la dispersión de los resultados dividida por la raíz cuadrada del recuento; el intervalo de confianza abarca aproximadamente dos de ellos a cada lado. Los costes desplazan el intervalo hacia abajo. Solo más operaciones, muchas más, lo estrechan. El setup tiene una ventaja cuando la barra queda por encima de cero después de costes, y no antes.
Cuántas operaciones
La pregunta que el nivel Intermedio respondió con “más de las que parecen necesarias” tiene una respuesta aritmética, y vale la pena verla porque es mayor de lo que admite la intuición.
La columna de la izquierda es el error estándar al revés: la muestra con la que dos errores estándar igualan la esperanza, de modo que el intervalo apenas excluiría el cero si la media del registro fuera la verdad. La columna de la derecha es la fórmula del manual del NIST para la muestra necesaria para detectar un desplazamiento de un tamaño dado (la suma de dos valores z, al cuadrado, por la dispersión entre el desplazamiento, al cuadrado), con el 5% convencional de probabilidad de un falso positivo y el 10% de no detectarlo. Es unas 2,7 veces la columna de la izquierda, porque no pide solo que la barra pueda superar el cero, sino que lo haga nueve de cada diez veces.
Las dos columnas dicen lo mismo sobre las ventajas pequeñas. Una esperanza de una décima de R es una ventaja real (en mil operaciones son cien R), y es también una que un setup que se activa dos veces por semana no puede demostrar en cinco años. Los setups que se pueden validar con un registro discrecional son aquellos cuya ventaja por operación es grande en relación con la dispersión de sus resultados. Es una restricción sobre lo que este nivel puede llamar honestamente una ventaja, y es mejor conocerla antes de abrir el cuaderno que después.
Lo que el intervalo no puede decir
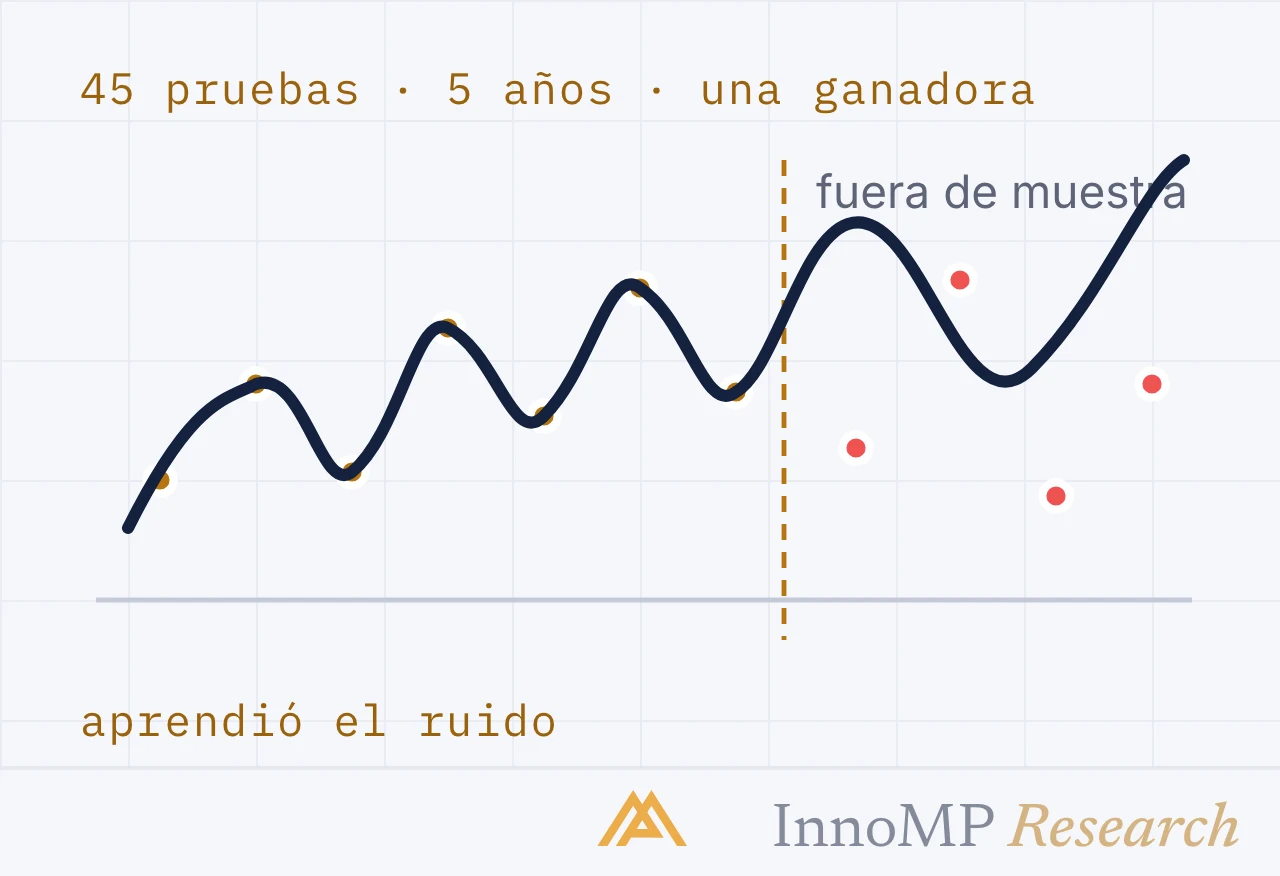
El intervalo describe la media, y trata el registro como una bolsa de resultados independientes cuyo orden no importa. Dos cosas se le escapan. El orden de las operaciones sí importa, para todo lo que tiene que ver con el drawdown: un registro con una buena esperanza matemática puede haber llegado por un camino que el trader no habría podido aguantar, y la parte siguiente remuestrea el registro para ver lo malos que eran los otros caminos. Y se supone que el registro es el único: si es el mejor de diez versiones de la regla, el intervalo es demasiado estrecho en una cantidad que depende de esas diez, que es donde termina el grupo.
Siguiente: Monte Carlo y drawdown: remuestrear las operaciones del registro para ver los drawdowns que su orden ocultaba, y fijar el tamaño para que los sorteos malos sean soportables.
- La esperanza matemática es la R media por operación; su error estándar es la desviación estándar de los resultados dividida por la raíz cuadrada del número de operaciones.
- Un intervalo de confianza para una media es la media más o menos un valor t multiplicado por el error estándar, y se estrecha con la raíz cuadrada de la muestra (NIST e-Handbook).
- Ilustrativo: 60 operaciones a +0,25R con una dispersión de 1,2R dan un intervalo del 95% de aproximadamente −0,05R a +0,55R; con 300 operaciones se estrecha a aproximadamente +0,11R a +0,39R.
- Cuatro veces más operaciones reducen la barra de error a la mitad; la misma precisión sobre una ventaja menor exige proporcionalmente más operaciones.
- El spread y el swap desplazan todo el intervalo hacia abajo sin estrecharlo, por lo que una ventaja se juzga después de costes.